| 新规之下, 档案机构可以怎么做?一个探索者的思考与倡议 |
| 发布日期:2026-11-06 来源:武汉云典智能科技有限公司 浏览次数:1679 字体: 小 中 大 |
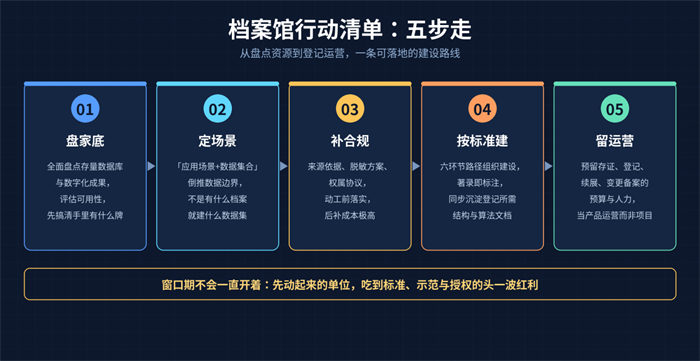
上一期,我们解读了湖北省十二部门联合印发的《数据知识产权登记管理办法》:数据集可以登记确权了,登记证书能用于授权交易、质押融资、资产入表,但来源、脱敏、权属三道合规关卡也同步立了起来。 政策解读完了,后台的问题也跟着变了——从“这是什么”变成了“那我们该怎么干?”。 回答这个问题之前,先跟大家交个底:云典自己也还在这条路的探索阶段,但探索不是从零开始。围绕高质量数据集建设的工具链,我们已经有了一批实打实的研发成果;而真正完整的行业落地案例——从档案资源到建成数据集、再到登记流通——我们还在探索之中。所以这最后一期,不夸大、也不妄自菲薄,把我们已经做成的工具、正在攻关的环节,和研究政策、观察行业形成的思考与设想一起摊开来讲。说得直白一点,这是一份抛砖引玉的“思路清单”,也是一份真诚的参与倡议——其中不成熟的地方,欢迎档案界的老师们批评指正。 一、先看清: 为什么说现在是窗口期? 三个条件正在同时成熟,这种重合并不常见。 政策条件成熟了。《高质量数据集建设指南》《国家数据基础设施建设指引》先后出台,2026年全国档案局长馆长会议明确提出稳妥运用人工智能等新技术;如今数据知识产权登记制度又把确权和变现的通道打开了。从“建什么”到“怎么建”再到“怎么流通”,政策链条第一次基本闭合。 需求条件成熟了。通用大模型缺优质中文语料,行业大模型缺垂直领域数据集,这个缺口是真实的、持续的。而档案资源恰恰在可信度、完整性、关联性上有别人替代不了的优势。 技术条件也成熟了。OCR、版面解析、自动标注、大模型辅助加工的成本这两年快速下降,过去不敢想的百万页级档案加工,现在技术上已经可行。 三个条件叠加,我们判断:先动起来的单位,有机会吃到标准制定、示范案例、市场授权的头一波红利。窗口期不会一直开着——当然,这只是我们基于行业观察的判断,仅供参考。 二、档案馆怎么入手: 我们设想的“五步走” 结合前两期讲的方法论和新规要求,我们试着为准备动手的档案馆梳理了一条参考路径。要说明的是,这五步来自政策文本、方法研究,也融入了我们在自研采集、清洗、审核工具链过程中的实践体会,但还没有经过完整数据集项目的全程验证,各单位实际情况千差万别,请结合自身条件取舍。 第一步,盘家底 对存量数据库、数字化成果做一次全面盘点和可用性评估:哪些资源完成了高阶数字化、元数据完整,可以优先转化;哪些还没数字化或质量不达标,列入补扫补录计划。不要急着买设备、上项目,先搞清楚手里有什么牌。 第二步,定场景 用“应用场景+数据集合”的思路选题:本地特色馆藏能不能做成文化类数据集?专业档案能不能支撑某个行业模型?开放审核、档案鉴定这些内部业务能不能先拿标注数据集练手?记住,不是有什么档案就建什么数据集,而是场景倒推数据边界。 第三步,补合规 三件事宜在动工前落实:来源依据(档案法利用依据或公共数据授权运营协议)、脱敏方案(涉密与个人信息的分级处理规则,并保留可审计记录)、权属协议(合作各方的投入与权益划分)。这三项直接对应登记办法的不予登记情形,后补的成本极高。 第四步,按标准建 按六环节路径组织建设:分析规划、数据采集、预处理、标注、模型验证、交付运维,全程留痕。特别强调两个习惯:标注前移到业务链,“著录即标注”;加工过程同步沉淀结构规模说明、算法规则文档——这些就是将来登记表的现成材料。 第五步,留运营 在项目设计里就预留存证、登记、续展、变更备案的预算和人力,把数据集当成一个要持续运营的产品来规划,而不是一个验收即结束的项目。
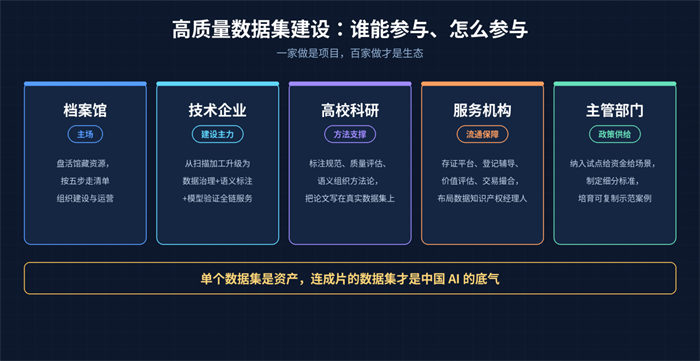
档案馆五步走行动清单 三、不只是档案馆的事: 谁都可以参与,怎么参与? 高质量数据集建设是个生态活,光靠档案馆自己干不成。以下几类主体的参与方式,是我们的一点设想:
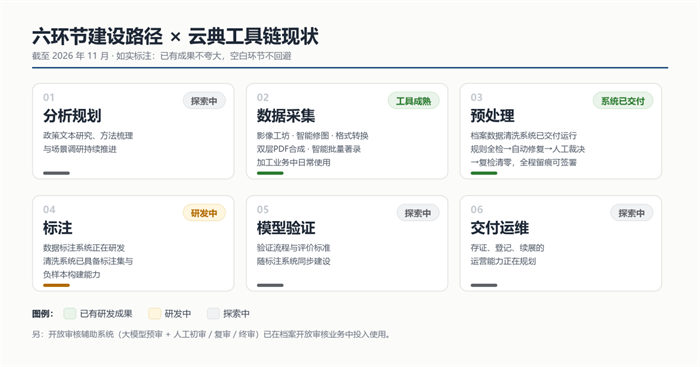
谁能参与、怎么参与 技术企业,可以把能力从“扫描加工”往“数据治理+语义标注+模型验证”延伸,未来谁能把数据集建成,谁就更有可能帮客户完成存证、登记、备案的全链条服务。办法里提出的“数据知识产权经理人”,也是一个值得关注的新角色。 高校和科研机构,可以在标注规范、质量评估、语义组织这些方法论环节多出力,把论文写在真实的数据集上,也让档案学科建设跟上数据要素时代。 知识产权服务、公证存证、数据交易机构,可以尽早研究数据知识产权登记与档案数据的结合点,存证平台、登记辅导、价值评估、交易撮合,每一环都可能生长出实实在在的服务需求。 行业主管部门,如果能在三个方面给予支持,基层的探索会顺利很多:一是把档案高质量数据集纳入本地数据要素和人工智能试点盘子,给予专项资金和场景开放支持;二是推动制定档案数据集的细分登记指引和建设标准,减少基层摸索成本;三是培育一批示范案例,像苏州丝绸纹样数据集那样可学、可看、可复制。 四、云典的定位: 做一个诚实的探索者 作为一家同样处在探索期的公司,云典智能科技不想把自己包装成专家,但也不愿妄自菲薄。如实向大家报告我们的位置:工具链已有实际研发成果,行业落地案例还在探索。 具体来说,围绕前文提到的六环节建设路径(分析规划、数据采集、预处理、标注、模型验证、交付运维),我们如实报告工具链的现状: 数据采集,工具已经成熟。文档影像处理流水线、智能修图、格式转换、双层PDF合成、智能批量著录等一整套工具,已在档案数字化加工业务中日常使用,扫描仪接入、OCR识别、本地大模型著录都经过了实际业务检验。 数据清洗,系统已经交付。我们自研的档案数据清洗系统已交付运行:标准条款驱动的规则全检,“形变义不变”才自动修复,疑难问题交人工裁决,复检清零后出具可签署报告,每一处改动都写入哈希链台账,原始数据只读不动。 人工审核,辅助系统已经投用。档案开放审核辅助系统采用“大模型预审只给建议、人工初审复审终审逐级把关”的人机协同模式,支持审核任务包导入导出,单机版与局域网多机版均已在实际业务中运行。 数据标注,系统正在研发。数据标注系统目前正在研发当中;清洗系统中的标注集与负样本构建能力已先行一步,可以把人工裁决的历史沉淀为可复用的样本资产。
六环节建设路径与云典工具链现状(截至2026年11月) 但探索不等于没有原则。我们给自己定的工作原则是三句话:场景先行,不做为建而建的工程;盘活存量,让已有数字化成果真正变成原料;闭环运营,让数据集不止于建成,更能登记、流通、持续增值。这些原则一部分来自工具研发的实践,一部分还要在完整的数据集项目里接受检验——做对了,我们会把方法分享出来;踩了坑,我们也会把教训写出来。 我们真诚地希望,有更多的档案馆、更多的同行机构一起加入这场探索。 这件事一家做是项目,百家做才是生态;单个数据集是资产,连成片的数据集才是中国 AI 的底气。 系列结语 这个系列三期,我们讲了三件事:第一期讲“是什么”——档案高质量数据集的概念与建设方法;第二期讲“新规则”——数据知识产权登记带来的确权与合规框架;这一期讲“怎么干”——一份有工具研发打底、仍在等待行业落地检验的思路清单和参与倡议。 档案是沉睡的资源,数据是流动的要素。把沉淀的历史资源转化为驱动人工智能发展的智慧动能,这条路才刚刚开始,好在我们不是空手上路。感谢每一位读到这里的朋友,后续我们会把探索中的思考、进展和踩过的坑继续写出来,欢迎持续关注、留言交流——也特别欢迎已经动手的单位联系我们,你们的实践经验,正是我们最想学习的东西。
武汉云典智能科技有限公司行业服务关键词:武汉档案整理、武汉档案公司、武汉档案整理公司、咸宁档案整理、咸宁档案公司、武汉档案数字化、咸宁档案数字化、湖北武汉档案整理、湖北武汉档案数字化、湖北武汉档案修复、咸宁档案修复、武汉档案、咸宁档案、湖北档案公司、湖北档案整理、武汉档案用品、咸宁档案用品、云典档案整理公司 |
 |
|
上一篇:湖北省数据知识产权登记管理办法解读 | 让数据集第一次有了“身份证” 下一篇:【档案学习】大事记编撰指南 |

|